Eine Genauigkeitszahl gibt es hier noch nicht
Auf dieser Website gibt es keine gemessene Wortfehlerrate für Voice Type, und diese Seite erfindet keine. Zu jeder Zahl, die wir veröffentlichen, gehört das Skript, das sie erzeugt hat. Der Benchmark für die Wortfehlerrate ist blockiert: Die App hat keinen Headless-Einstiegspunkt, deshalb lässt sich ein Korpus nicht ohne einen Menschen an der Tastatur durch die Erkennung schicken. Solange es diesen Einstiegspunkt nicht gibt, ist keine der Zahlen unten eine Genauigkeitszahl. Es sind Zahlen zu Übertragung und Nutzlast, und man sollte das eine nicht mit dem anderen verwechseln. Behandle Genauigkeitsprozente von Anbietern, unsere eingeschlossen, sobald es sie gibt, als bedeutungslos, solange kein benannter Korpus und kein wiederholbares Skript dahinterstehen.
Der feste Preis, den eine Cloud-Anfrage zahlt, bevor Audio übertragen wird
Gemessen auf einem Apple M1 Pro, macOS 26.5.1 Build 25F80, über WLAN zu Hause am 2026-08-29. Zwölf Durchläufe pro Endpunkt. Es wurden weder ein API-Schlüssel noch Audio gesendet, die gemessene Antwort ist also eine Ablehnung ohne Authentifizierung: ein echter Round Trip bis zum Edge des Anbieters ohne jede Inferenz. Skript zum Nachmessen: bench/connsetup.py --profile wifi --repeat 12, Rohdaten in bench/results/03-connection-setup-20260829T065129Z.json.
| Endpunkt | Aufbau vor dem ersten Audio, Median | p95 |
|---|---|---|
| api.openai.com | 30.9 ms | 61.0 ms |
| api.deepgram.com | 514.9 ms | 766.2 ms |
| Auf dem Gerät | entfällt komplett | entfällt komplett |
Gleicher Rechner, gleiche Verbindung, gleiche Minute, und die Fixkosten unterscheiden sich um den Faktor 17 zwischen zwei gut betriebenen Anbietern. Deepgram ist kein langsamer Dienst; der mediane TCP-Verbindungsaufbau von 252.9 ms zeigt einen vom Mac aus weit entfernten Point of Presence. Die Einschränkungen gehören zur Zahl: Der DNS-Cache von macOS war nach der ersten Anfrage warm, das ist ein Rechner an einer Verbindung zu einem Zeitpunkt, und eine echte Anfrage lädt zusätzlich Audio hoch und wartet auf ein Modell, und zwar obendrauf auf diese Untergrenze.
Was dreißig Minuten Diktat wiegen
Bytes, gemessen durch Kodieren von echtem Audio. Skript zum Nachmessen: bench/payloadsize.py, Rohdaten in bench/results/05-payload-size-20260829T070405Z.json. Eine Cloud-Erkennung muss eine der ersten drei Zeilen erhalten. Eine Erkennung auf dem Gerät erhält keine davon.
| 30 Minuten Diktat als | Hochgeladen |
|---|---|
| Rohes 48-kHz-WAV | 172.8 MB |
| 16-kHz-WAV | 57.6 MB |
| Opus 24k | 5.25 MB |
| Auf dem Gerät | 0 Bytes |
Eine Einschränkung, die die verlustbehafteten Zeilen betrifft: Dieser Durchlauf hat den synthetischen say-Korpus kodiert statt menschlicher Sprache, und Opus und AAC arbeiten mit variabler Bitrate, ihre Größen schwanken also mit dem Inhalt. Die WAV-Zeilen sind davon nicht betroffen.
Was die Erkennung tatsächlich bekommt
Ein von Whisper abgeleitetes Modell erwartet 16-kHz-Mono-Sprache in einem ziemlich engen Lautstärkebereich. Ein MacBook-Mikrofon liefert dagegen 48-kHz-Audio in dem Pegel, den der Raum und deine Sitzposition ergeben, mit Tischklopfen und Gebäudebrummen darunter. Die Aufbereitungskette schließt diese Lücke. Jede Stufe behebt einen bestimmten Mangel, und die Reihenfolge ist festgelegt, weil eine spätere Stufe davon abhängt, dass die frühere schon gelaufen ist.
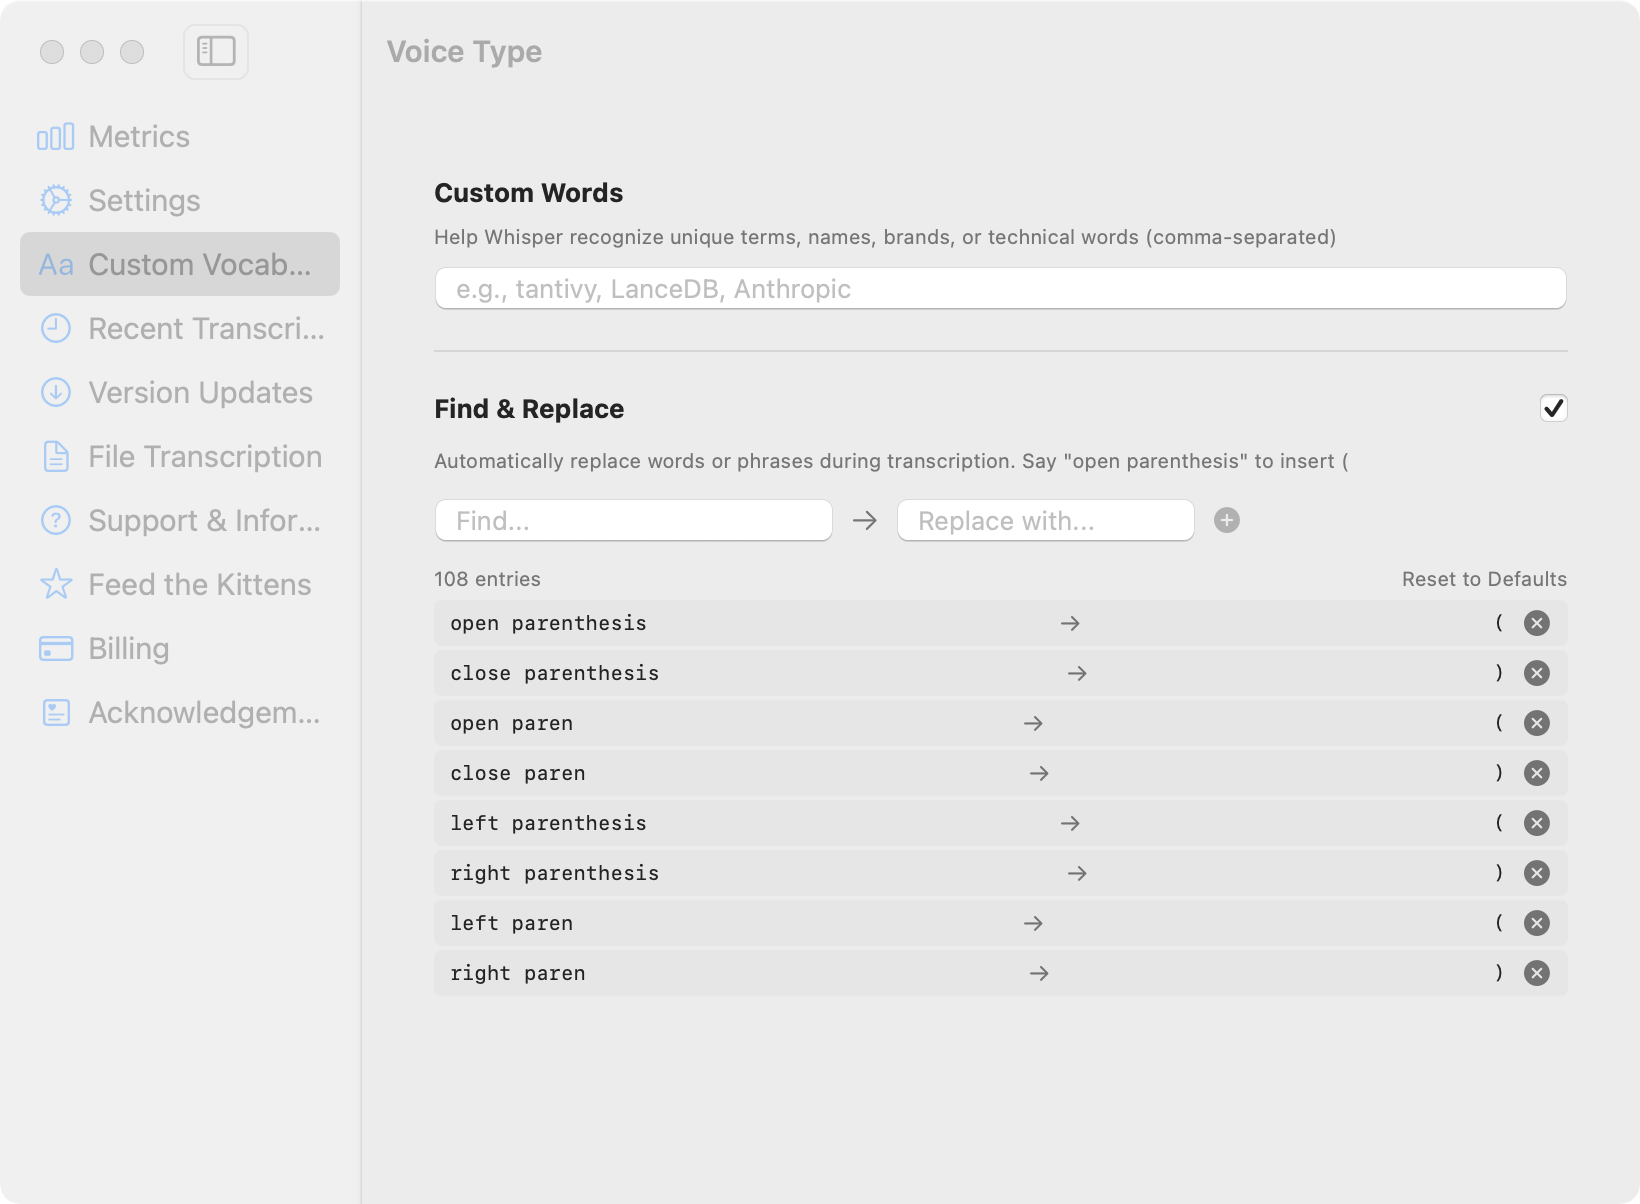
Die Stufen und der Mangel, den jede behebt
- Silero-Sprachaktivitätserkennung: Ein Streaming-Sprach-Gate markiert Sprachinseln, sodass Stille und gleichmäßiges Hintergrundrauschen nie bis zur Dekodierung gelangen und die Erkennung nicht einen Lüfter transkribieren soll.
- Hochpassfilterung: Ein 50-Hz-Hochpass entfernt Tischklopfen, Schritte und Gebäudebrummen, die unterhalb des Sprachbands liegen und Headroom fressen.
- Lautheitsnormalisierung: Die K-gewichtete Normalisierung gleicht den Abstand zum Mikrofon und die Lautstärkeschwankungen aus, die entstehen, wenn du dich mitten im Satz zurücklehnst. Der Zielwert hängt vom Pfad ab: −14 LUFS für die Dateitranskription, standardmäßig −16 LUFS für Live-Diktat, −18 LUFS bei der alternativen Live-Topologie.
- Bandbegrenztes Resampling: 48 kHz auf 16 kHz über einen Tiefpass, damit Anteile oberhalb von 8 kHz nicht als Aliasing ins Sprachband zurückfalten, das der Sprecher nie erzeugt hat.
- Keine korrigierende Prompt-Schicht: Wir lassen kein grobes LLM-Aufräumen über das Transkript laufen. Das lässt die Ausgabe selbstsicher klingen, während sie sich von dem entfernt, was gesagt wurde, und das ist die schlimmste Art von Genauigkeitsfehler, weil man ihn nicht sieht.
Was keine Stufe dieser Kette behebt
- Ein schlechtes Mikrofon: Die Aufbereitung skaliert und filtert, was da ist. Sprachenergie, die die Aufnahme nie enthielt, kann sie nicht zurückholen.
- Überlagernde Sprache: Das Gate erkennt Sprache. Eine andere Person, die spricht, ist Sprache, also kommt sie durch.
- Eigennamen, die das Modell nie gesehen hat: Eigener Wortschatz hilft, aber ein ungewöhnlicher Nachname oder ein interner Codename wird trotzdem manchmal falsch herauskommen.
- Ein Kategoriefehler: Keine Diktier-App ersetzt die Sprachsteuerung, wenn es eigentlich darum geht, macOS freihändig zu bedienen.
Wo die technischen Details stehen
- Bandbegrenztes Resampling von 48 auf 16 kHz, einschließlich dessen, wie Aliasing klingt, wenn der Filter fehlt.
- Die Pipeline auf dem Gerät, Schritt für Schritt, vom Sprach-Gate bis zur Inferenz auf Metal.