중요한 질문은 클라우드 음성 인식이 “빠른가”가 아닙니다. 말을 멈춘 뒤 시간이 어디로 사라지느냐입니다. 로컬 워크플로는 업로드 지연과 서버 왕복을 없앨 수 있습니다. 클라우드 워크플로는 그럴 수 없습니다.
내 API 키로 정리
RTT 60ms · 업로드 5 Mbps
클라우드 받아쓰기
오디오 업로드 → 클라우드 STT
Voice Type
로컬 STT → LLM 다듬기
오디오는 Mac 안에만 머뭅니다. LLM에는 텍스트만 전달됩니다.
Voice Type이 11s 더 빠릅니다 (대기 시간 80% 감소)
계산 상세
• 클라우드 오디오: 128 kbps, STT는 실시간의 약 50배 속도
• 기기 내 처리: M1 Pro에서 확정에 약 1.2초
• LLM: Cerebras 초당 약 1000토큰
• 말하기 속도: 약 225 wpm (빠르게 말하는 경우)
데모 읽는 법
- 클라우드 경로에는 네트워크 핸드셰이크, 업로드 시간, 인식 시간, 서비스 오버헤드가 포함됩니다.
- 로컬 경로는 음성 인식을 기기 안에서 처리하며, 외부 텍스트 다듬기를 요청할 때만 추가 시간이 듭니다.
- 요점은 마법 같은 숫자 하나를 내놓는 것이 아닙니다. 오디오가 기기를 벗어나지 않아도 될 때 경로의 어떤 부분이 사라지는지 보여 주는 것입니다.
모델의 가정
이 인터랙티브 데모는 단순하고 명시적인 가정을 사용합니다. 네트워크 왕복 시간, 업로드 대역폭, 대략적인 클라우드 변환 속도, 그리고 마지막 음성 구간에 대한 로컬 확정 단계입니다. 그래서 솔직한 모델입니다. 실제 제공업체마다 차이는 있지만 지연의 구조는 같습니다.
이는 스트리밍 음성 시스템이 보통 문서화되는 방식과 같습니다. 오디오를 잘게 나누어 실시간 스트림으로 보내고, 조금씩 처리한 다음, 말이 끝난 뒤 확정합니다. 네트워크 지연이 크고 업로드가 느릴수록 그 비용은 어딘가에서 치러야 합니다.
실제 사용에서 왜 중요한가
- 빠른 광랜에서 한 줄 메모를 남길 때는 클라우드 지연도 괜찮게 느껴질 수 있습니다.
- 평소 작업 중에 짧은 받아쓰기를 반복하면, 추가되는 1초마다 불편이 쌓입니다.
- 호텔의 나쁜 Wi-Fi, 기차 안, 오프라인 상황에서는 차이가 속도가 아니라 워크플로가 아예 작동하느냐의 문제가 됩니다.
로컬 경로를 실제로 측정하면
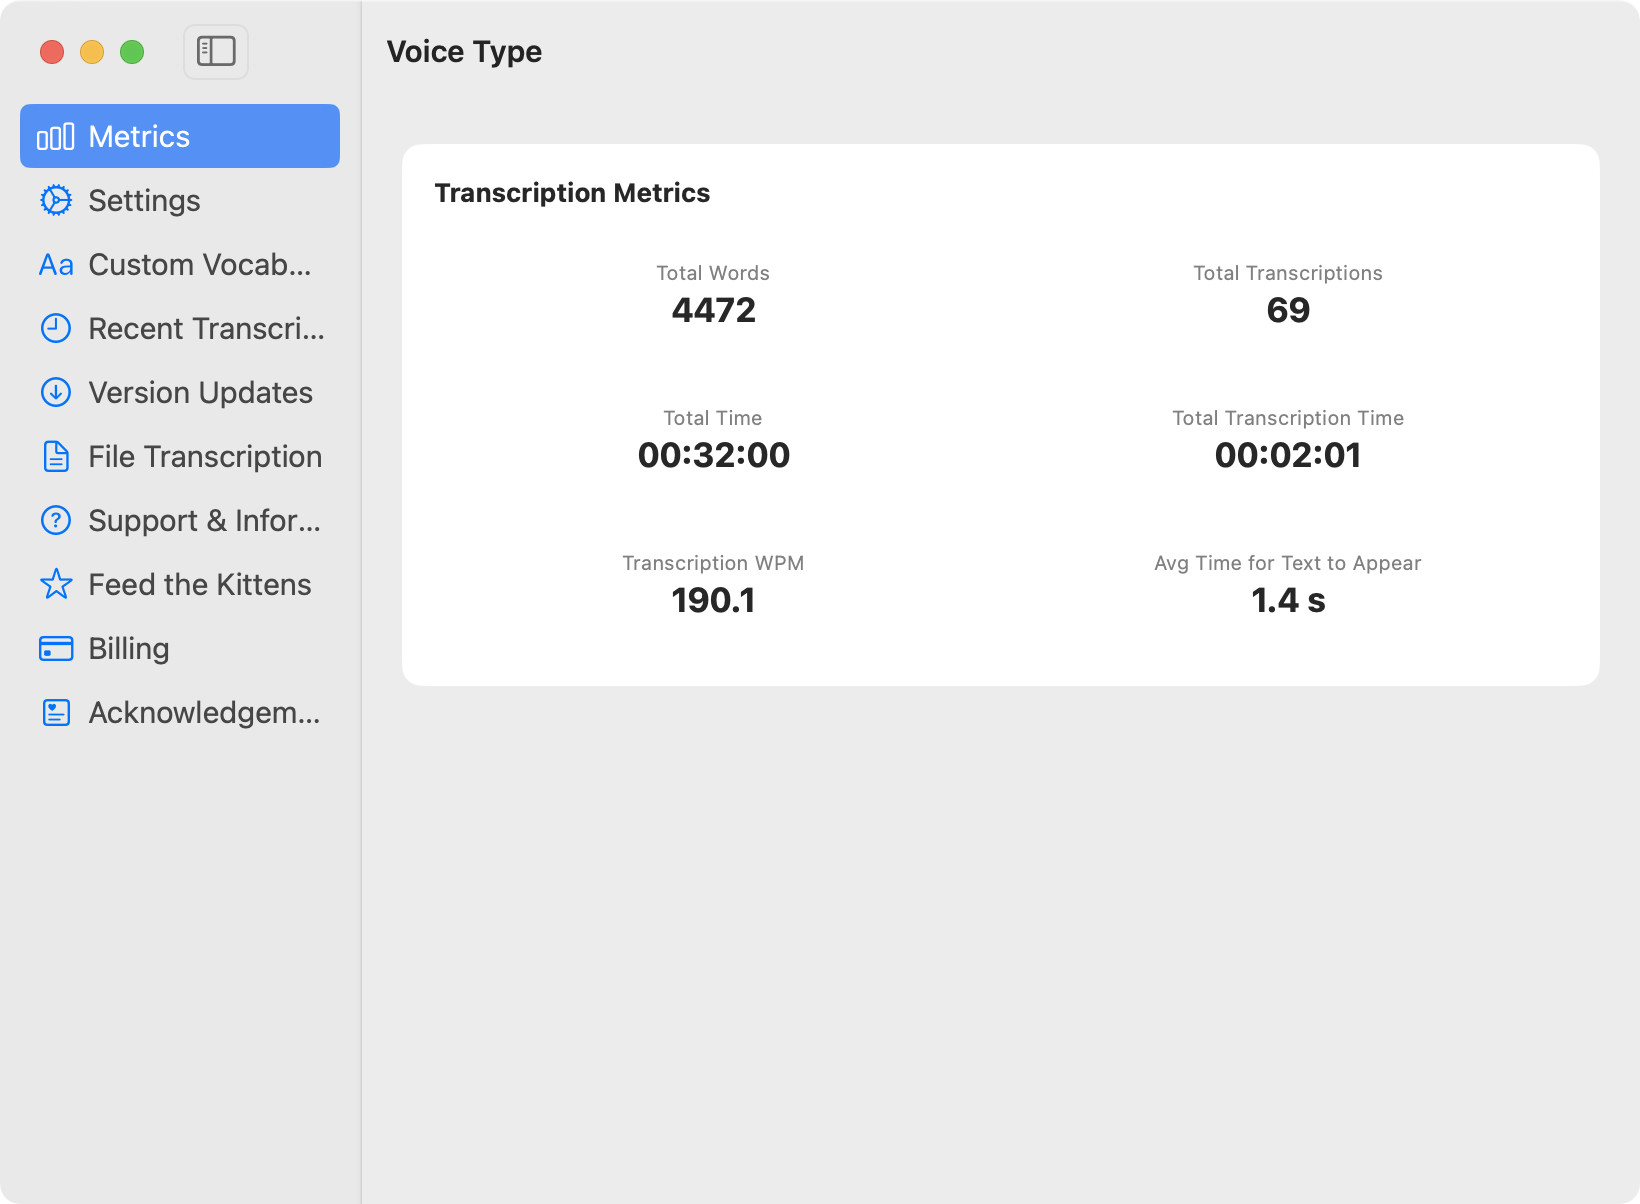
위의 데모는 모델입니다. 앱도 자체 카운터를 갖고 있어서, 모델의 로컬 쪽에는 나란히 놓을 실제 수치가 있습니다. 아래 세션은 69번의 변환에서 말이 끝난 뒤 화면에 텍스트가 나타나기까지 평균 1.4초가 걸렸고, 이 경로에는 업로드도 왕복도 없었습니다.
참고 자료
Voice Type은 오디오 경로를 로컬에 유지합니다. 선택적인 다듬기에는 직접 쓰는 LLM을 사용할 수 있지만, 음성 인식 단계는 네트워크를 기다릴 필요가 없습니다.
7일 무료 체험 시작하기