大切なのは、クラウド音声認識が「速い」かどうかではありません。話し終えてからの時間がどこで消えているかです。ローカルのワークフローなら、アップロードの待ち時間もサーバーとの往復もなくせます。クラウドのワークフローにはそれができません。
自分の API キーで整形
RTT 60ms · 上り 5 Mbps
クラウド音声入力
音声をアップロード → クラウド STT
Voice Type
ローカル STT → LLM 書き換え
音声は Mac の中にとどまります。LLM に送られるのはテキストだけです。
Voice Type は 11s 速い(待ち時間 80% 減)
計算の詳細
• クラウドの音声: 128 kbps、STT は実時間の約 50 倍の速さ
• オンデバイス: M1 Pro で確定に約 1.2 秒
• LLM: Cerebras 毎秒約 1000 トークン
• 話す速さ: 約 225 wpm(早口)
デモの見方
- クラウドの経路には、ネットワークのハンドシェイク、アップロード時間、認識時間、サービス側のオーバーヘッドが含まれます。
- ローカルの経路では音声認識をデバイス上で行い、外部のテキスト書き換えを使うときだけ追加の時間がかかります。
- 目的は、魔法のような 1 つの数字を出すことではありません。音声を Mac の外に出さずに済むと、経路のどの部分がなくなるのかを示すことです。
モデルの前提
このインタラクティブなデモは、単純で明示的な前提を使っています。ネットワークの往復時間、アップロード帯域、おおまかなクラウドの文字起こし速度、そして発話の最後の部分に対するローカルでの確定処理です。だからこそ誠実なモデルといえます。実際のプロバイダーごとに違いはありますが、遅延の構造は変わりません。
これは、ストリーミング音声システムが一般的に説明されている仕組みと同じです。音声は小さく区切られ、ライブのストリームで送られ、少しずつ処理され、発話が終わった後に確定されます。ネットワークの遅延が大きいほど、アップロードが遅いほど、その分はどこかで払うことになります。
実際の利用でなぜ重要か
- 高速な光回線で一言のメモを取るだけなら、クラウドの遅延は許容できると感じるかもしれません。
- 普段の作業で短い音声入力を何度も繰り返すと、1 秒ごとの余計な待ち時間が積み重なってストレスになります。
- 電波の悪いホテルの Wi-Fi、電車の中、オフラインの状況では、違いは速度ではなく、そもそもワークフローが成り立つかどうかになります。
ローカルの経路を実際に計測すると
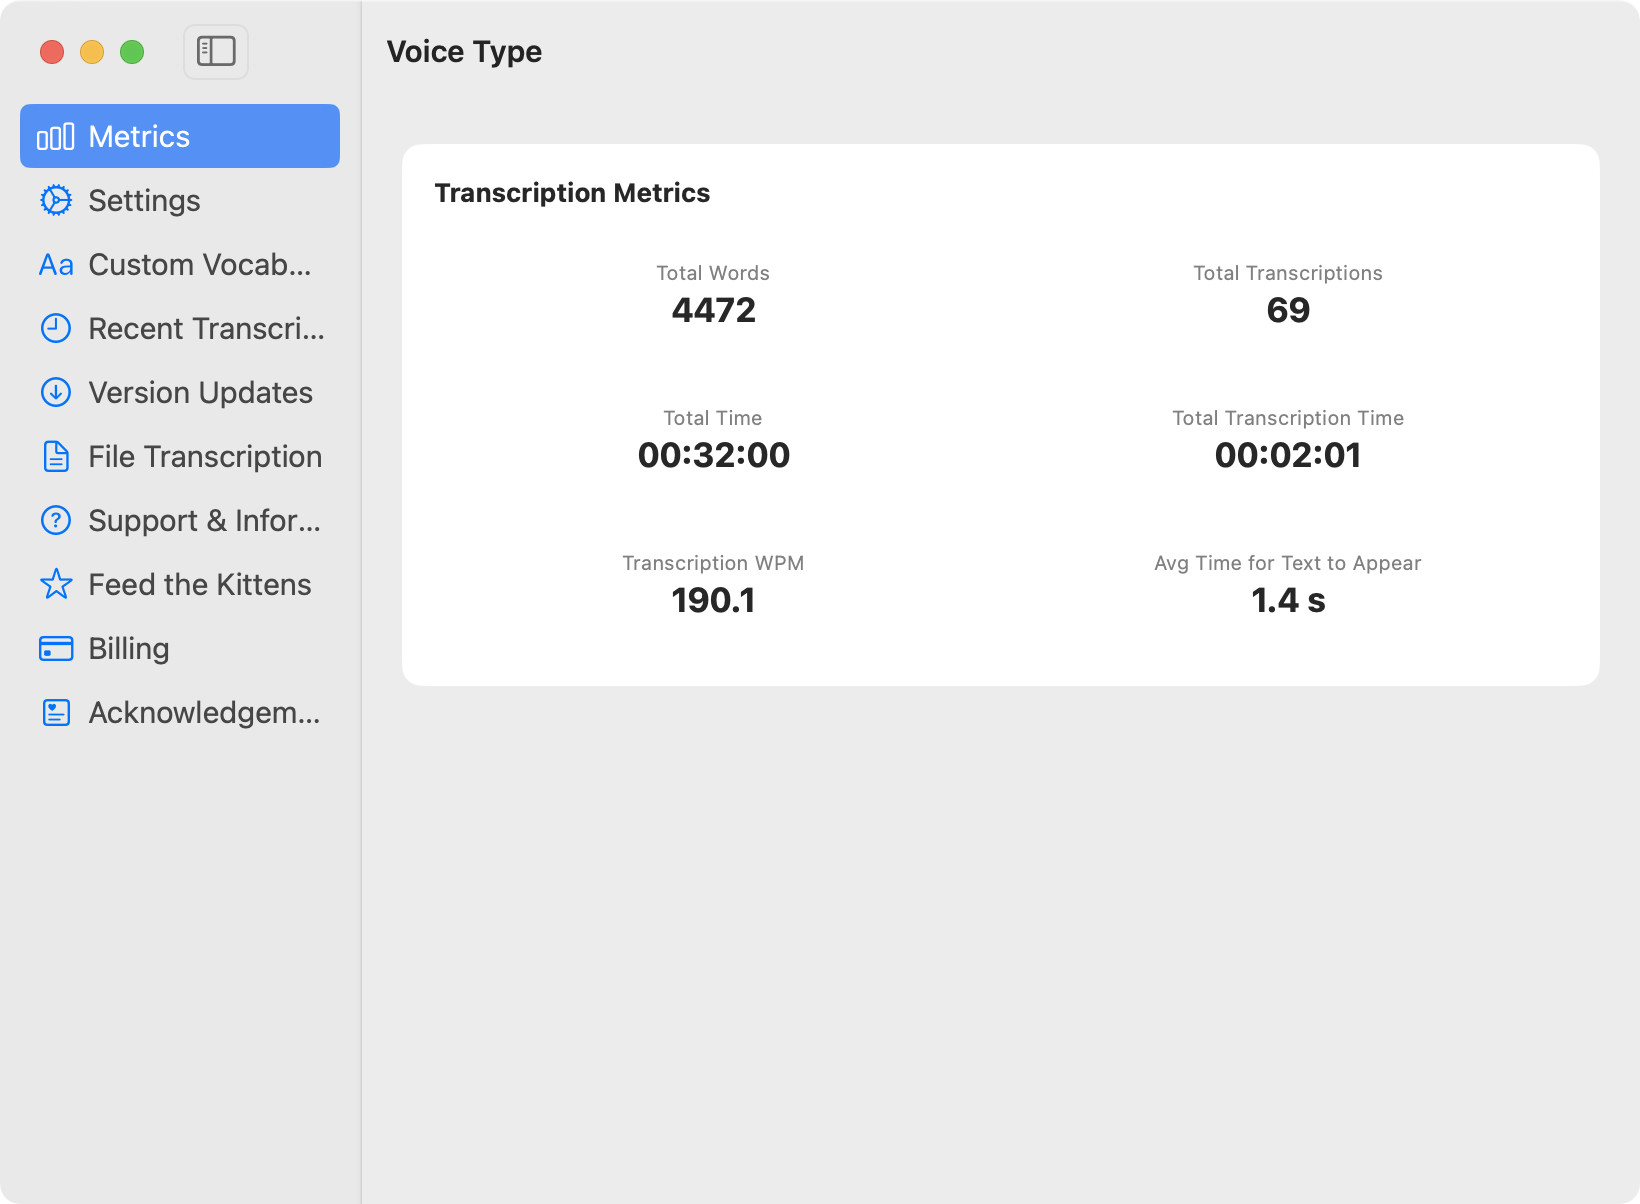
上のデモはモデルです。アプリ自体も独自のカウンターを持っているので、モデルのローカル側にも実測値を並べられます。下のセッションでは、69 回の文字起こしで、話し終えてから画面にテキストが表示されるまでの平均が 1.4 秒でした。この経路にはアップロードも往復もありません。
参考文献
Voice Type は音声の経路をローカルに保ちます。オプションの書き換えには引き続きご自身の LLM を使えますが、音声認識の段階でネットワークを待つ必要はありません。
7 日間の無料トライアルを試す